字典树学习笔记
1.前言
在处理一些前缀、匹配的问题时,普通的暴力是无法解决的
这个时候,除了hash,我们还有字典树
2.字典树框架
字典树,又称Trie树,一种树形结构
它的操作可以理解为将字符串加入一个集合
字典树需支持两个操作:
- 插入,将字符串T加入集合中
- 查询,查询一个字符串S与集合中的字符串的匹配、词频等信息
根据以上两个要求,先辈们发明了一种树形结构,性质如下:
- 根节点不包含任何字符
- 从根节点到某一节点,路径边上经过的字符连接起来 ,为该节点对应的字符串
- 每个节点与所有子节点的连接边包含的字符都不相同
字典树在边上存储字符信息
放个图理解:
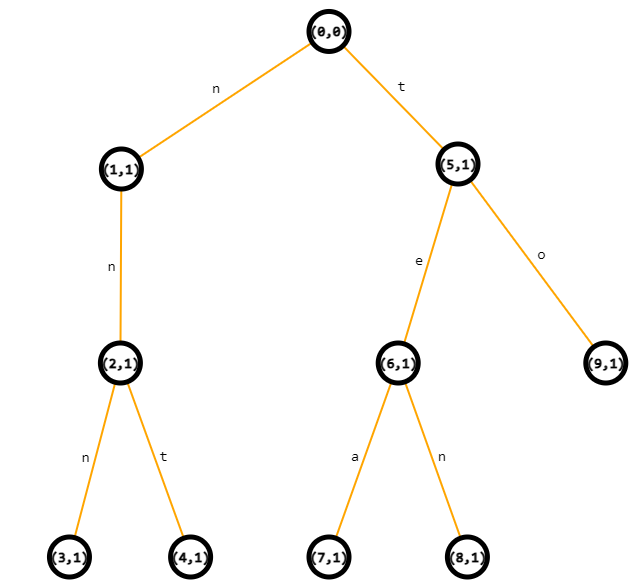
其中,每个点上都有个数对 $(x,y)$ ,$x$ 是该节点的编号,记节点 $x$ 代表的字符串为 $S$ , $y$ 就是前缀 包含 $S$ 这个字符串的集合中的 字符串的数量
所以这张图就代表了这样一个字符串集合:
$$
{nnn,nnt,tea,ten,to}
$$
这时候,我们发现查询和插入就很简单了
查询字符串 $S$ 时,从根节点出发,找到边上字符为 $S_1$ ($S$ 的第一个字符)的边,加上信息,找到下一个节点,以此类推
插入字符串 $T$ 时,也从根节点出发,查询是这个节点是否有字符为 $T_1$ 的边,有则到达边指向的下一个节点,没有则新建这条边以及边指向的节点,到达这个新建节点,以此类推
存储方式也很简单,就像这样:
1 | |
3.应用
(1)前缀匹配类
- 模板:前缀统计
- 稍微变了点:前缀nowcoder(My题解)
- 字典树上dfs:Wild Words,POJ挂了,所以放的Vjudge的地址,My题解
字典树学习笔记
https://zxtweb.fun/posts/cnb-19603548/